Projekte
Projekte
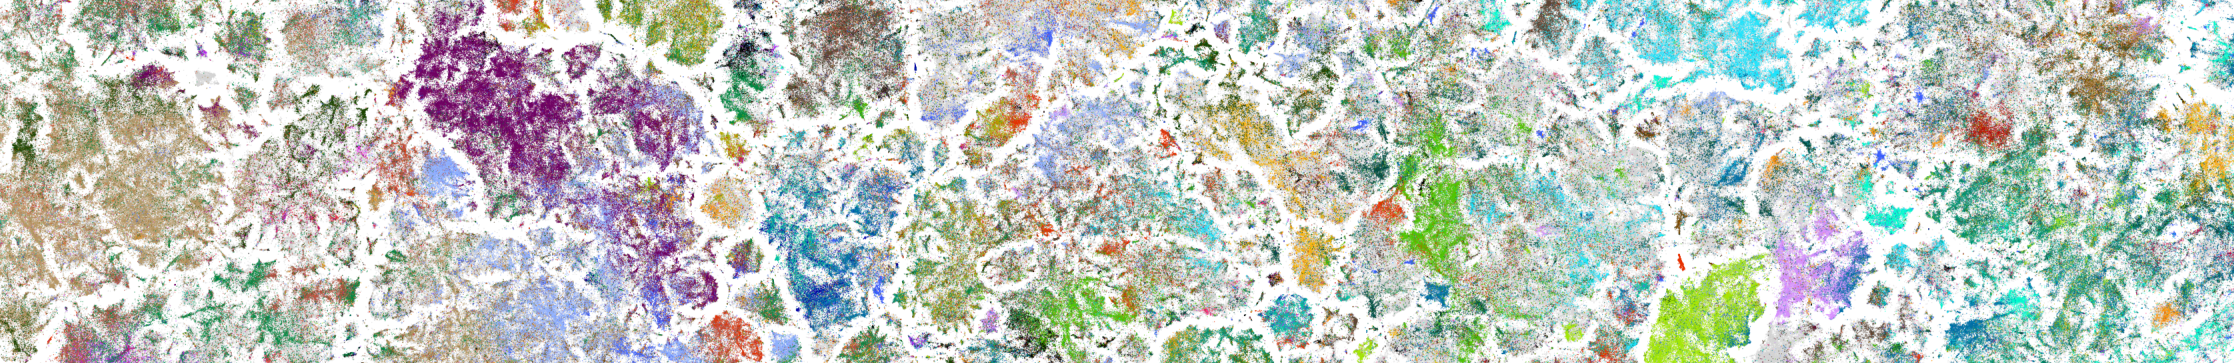
PubMed-Landschaft
Ein 2D-Atlas von über 21 Mio. biomedizinischen Abstracts, erstellt aus Text-Embeddings, zur Untersuchung der Entstehung von Forschungsfeldern und der Dynamik der COVID-19-Forschung.
Excess Vocabulary durch LLMs
Erkennt die Spuren von LLM-unterstütztem Schreiben in über 15 Mio. biomedizinischen Abstracts, indem Verschiebungen im Wortgebrauch über die Zeit nachverfolgt werden.
Text-Visualisierungen
Ein SBERT-basierter Projektor, der end-to-end mit einem kontrastiven, t-SNE-ähnlichen InfoNCE-Loss trainiert wird und 2D-Text-Embeddings erzeugt, die gleichzeitig eine gute Visualisierung und ein gutes Sentence-Embedding darstellen.
Cropping vs. Dropout: Augmentierung von Text-Embeddings
Begleitcode zu unserem TMLR-Paper, das selbstüberwachte Fine-Tuning-Strategien für Text-Embedding-Modelle vergleicht und zeigt, dass cropping-basierte Augmentierung Dropout übertrifft.
LLM-Lesbarkeit
Quantifiziert, wie LLM-unterstütztes Schreiben die Lesbarkeit biomedizinischer Abstracts verändert hat, die zwischen 2010 und 2025 veröffentlicht wurden.
ICLR-Datensatz
Ein offener Datensatz von über 24.000 ICLR-Einreichungs-Abstracts (2017-2024) mit Entscheidungen und keyword-basierten Labels, genutzt zur Untersuchung von Trends in der Machine-Learning-Forschung.